
Schema Author JSON-LD Hilang dari Rich Results? Ini Fix
Schema author JSON-LD lo bisa hilang diam-diam dari rich results Google gara-gara referensi @id yang gak resolve. Ini 4 fix-nya plus update Google Agustus 2026.
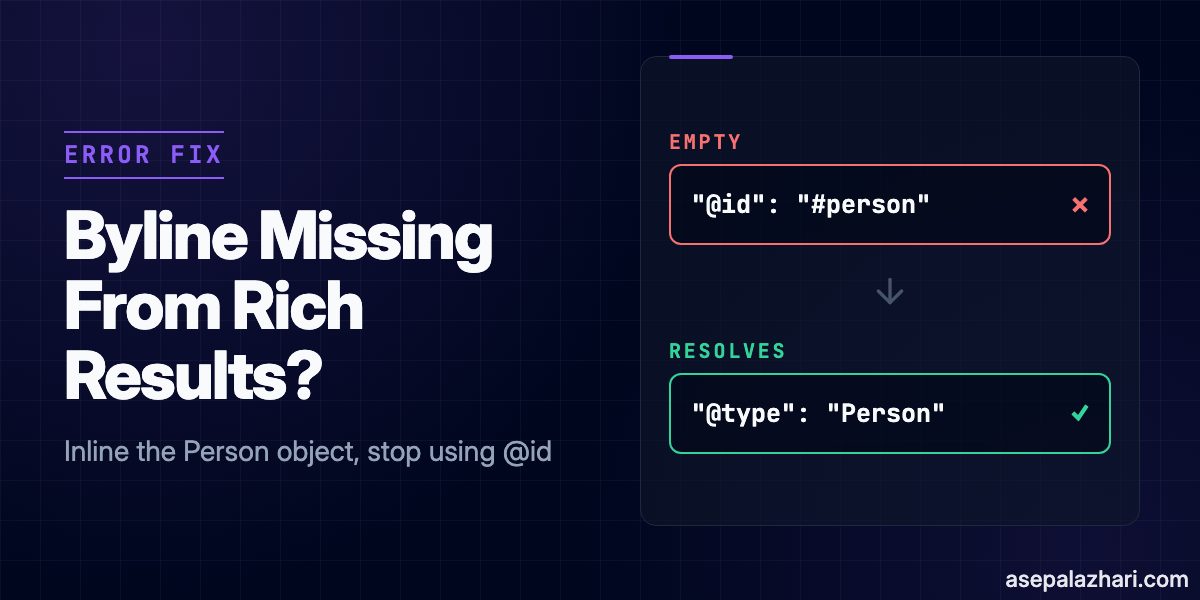
Kebanyakan tutorial JSON-LD nyaranin lo nge-link author pakai referensi @id, biar semua artikel ke-merge ke satu entity di mata Google. Padahal saran itu justru yang bikin author detection-nya rusak, dan rusaknya diam-diam. Gak ada error di Google Search Console, gak ada warning di Rich Results Test, byline-nya cuma diem-diem berhenti dihitung buat eligibility.
Versi singkatnya: @id itu cuma pointer, dan pointer cuma resolve kalau node yang dia tunjuk beneran ada di dalam dokumen JSON-LD yang sama. Kalau lo arahin ke node Person yang didefinisiin di tempat lain, entah di script block lain, di halaman lain, atau di graph level sitemap, Google bakal baca artikel lo seolah author-nya gak punya nama. Di bawah ini ada empat bug schema yang bikin ini kejadian, gue urutin dari yang paling sering gue temuin, plus satu perubahan baru dari Google per 20 Agustus 2026 yang tetep worth dicek walau markup author lo udah bener.
Fix Cepat: Inline Object Person-nya
Kalau lo cuma mau benerin satu hal, benerin ini. Berhenti referensiin node Person eksternal pakai @id, langsung inline aja full object-nya di dalam author.
// Sebelum: rusak diam-diam
{
  "@type": "Article",
  "author": { "@id": "https://example.com/#person-jane-doe" }
}

// Sesudah: self-contained, resolve terus
{
  "@type": "Article",
  "author": {
    "@type": "Person",
    "name": "Jane Doe",
    "url": "https://example.com/author/jane-doe",
    "sameAs": ["https://www.linkedin.com/in/janedoe"]
  }
}
Referensi @id itu cuma label, bukan lookup ke database. Crawler Google gak nge-fetch halaman lain buat resolve dia. Kalau object Person yang lengkap gak ada di dokumen yang sama pas di-parse, referensinya nunjuk ke kosong, dan yang Google catat buat author itu ya kosong.
Kenapa Ini Kejadian: Empat Bug Schema, Satu Gejala
| Bug | Gejala | Fix |
|---|---|---|
@id eksternal buat author | Author kebaca kosong, byline hilang dari rich results | Inline object Person-nya |
| Nama author gak di-encode di URL | URL profil author jadi rusak atau kepotong | Percent-encode nama sebelum di-interpolate |
Organization pakai ulang logo buat image | Rich result Local Business gak eligible | Tambahin field image yang beda sendiri |
@type di-hardcode di semua post | Review dan produk kehilangan tipe rich result spesifiknya | Bedain @type berdasarkan tipe konten |
Fix 2: Percent-Encode Nama Author
Nama author yang ada spasi, aksen, atau karakter non-ASCII bakal rusak kalau di-interpolate mentah-mentah ke field URL. Nama kayak “José García” atau “Nguyễn Văn” langsung jadi segment URL yang invalid begitu lo template-string-kan.
const authorUrl = `https://example.com/author/${encodeURIComponent(authorName)}`;encodeURIComponent itu fix satu baris doang. Jalanin ini ke nama sebelum masuk ke field url atau sameAs manapun di JSON-LD, jangan sesudahnya.
Fix 3: Kasih Organization Image Sendiri, Beda dari Logo
Schema Organization sering pakai value yang sama buat logo dan image. Itu masih works buat knowledge panel Organization, tapi bikin gak eligible buat rich result yang spesifik butuh image yang beda dari logo, terutama rich result Local Business.
{
  "@type": "Organization",
  "name": "Example Inc",
  "logo": "https://example.com/logo.png",
  "image": "https://example.com/office-photo.jpg"
}
Dokumentasi structured data Organization resmi dari Google emang misahin image dan logo jadi dua property beda dengan alasan. Isi dua-duanya, dan arahin ke asset yang beda.
Fix 4: Bedain Tipe Schema Berdasarkan Konten
@type: "Article" yang di-hardcode di semua post bikin lo buang eligibility buat tipe rich result yang lebih spesifik. Review produk butuh Review dengan reviewRating. Post berita lebih cocok pakai NewsArticle ketimbang Article biasa. Post perbandingan yang me-review produk fisik atau digital bisa bawa Product bareng schema-nya.
function getSchemaType(post: { category: string; hasRating?: boolean }) {
  if (post.hasRating) return "Review";
  if (post.category === "news") return "NewsArticle";
  return "Article";
}
Map ini sekali aja di level template, berdasarkan field category atau content-type yang udah ada di CMS lo, dan tiap post bakal otomatis ngeluarin tipe schema yang emang dia layak dapetin.
Perubahan Agustus 2026: Entity Double-Escaped Gak Auto-Correct Lagi
Ini kasus terpisah dari empat bug di atas, dan ini baru. Per 20 Agustus 2026, Google ubah cara Googlebot nge-extract JSON-LD: sekarang cuma satu pass HTML unescaping yang jalan, bukan resolve entity berulang-ulang. Gary Illyes konfirmasi perubahan ini biar parser-nya selaras sama spesifikasi JSON, RFC 8259 section 7, yang ngatur escaping cuma sekali, bukan rekursif.
Sebelum perubahan ini, kalau generator JSON-LD lo nge-escape value dua kali, misal ampersand ditulis jadi & atau checkmark jadi entity double-escaped, Googlebot diem-diem unescape dua kali dan tetep kebaca karakter yang bener. Sesudah perubahan ini, cuma satu pass unescaping yang jalan. Entity yang double-escaped sekarang kebaca sebagai karakter sampah di value yang di-parse, atau langsung gagal validasi.
Risiko ini hampir sepenuhnya ada di sistem berlapis, bukan script yang ditulis manual satu layer. Pola klasiknya: CMS nge-escape value buat output HTML yang aman, terus plugin atau template layer lain nge-escape ulang value yang sama pas nge-serialize block JSON-LD-nya. Tiap layer bener kalau diliat sendiri-sendiri. Ditumpuk, jadinya double-escape.
Fix-nya adalah berhenti ngandelin double-escaping dari awal. Pakai standard JSON string escape atau Unicode hex escape (enam karakter backslash, u, 0, 0, 2, 6 buat ampersand) di titik value-nya di-serialize jadi JSON, dan pastiin gak ada apapun di upstream yang nge-HTML-escape value yang sama buat kedua kalinya.
// Serialize pakai JSON.stringify, jangan pre-HTML-escape value-nya duluan
const jsonLd = JSON.stringify({
  "@type": "Article",
  headline: rawTitle, // pass string mentah, biar JSON.stringify yang escape sekali
});
Kalau lo pakai CMS, ekosistem plugin, atau pipeline apapun di mana lebih dari satu layer nyentuh string yang sama sebelum jadi JSON-LD, audit sekarang. Site yang paling kecil kemungkinan kena adalah yang schema-nya dibangun dan di-serialize dalam satu fungsi doang.
Cara Verifikasi Fix-nya
Google Search Console gak selalu nunjukin error eksplisit buat author yang hilang diam-diam. Cek dengan cara ini aja.
- Jalanin halaman spesifiknya lewat Rich Results Test punya Google, expand item yang kedeteksi.
- Pastiin field
authornunjukinnameyang resolve, bukan object kosong atau string@iddoang. - Di Search Console, buka Search Appearance, terus Rich Results, cari tipe item yang halaman lo target. Halaman yang gak muncul sama sekali di situ, dengan nol error, sering kali itu kasus silent-nya: dia emang dari awal gak pernah eligible.
- Sesudah deploy fix, request indexing buat halamannya, tunggu crawl berikutnya, terus klik Validate Fix di Search Console buat mastiin Google udah baca dengan bener.
Baca Juga: GEO 2026: Biar Blog Lo Dikutip ChatGPT, Claude, Perplexity
Apa Fixing Ini Jamin Rich Result Muncul?
Enggak. Structured data yang valid dan resolve bikin halaman lo eligible, bukan maksa Google nampilin enhanced result-nya. Google nentuin tampilannya berdasarkan intent query dan sinyal kualitas halaman, di atas schema-nya yang emang bener. Benerin empat bug ini ngilangin silent failure yang bikin gak eligible dari awal, dan itu bagian yang emang bisa lo kontrol.
Baca Juga: IndexNow: Langsung Kasih Tau Search Engine Ada Update Terbaru
Pertanyaan yang Sering Diajukan
Apa perubahan Agustus 2026 ini ngaruh ke schema FAQPage atau HowTo juga? Iya, ini ngaruh ke value JSON-LD manapun yang sebelumnya ngandelin HTML unescaping berulang, apapun tipe schema-nya. Fix-nya sama: escape sekali, pas serialization, dan berhenti double-escape di upstream.
Perlu gak gue benerin ini kalau site gue gak pakai tipe NewsArticle atau Review? Bug @id dan percent-encoding berlaku ke node author atau Organization manapun, apapun parent type-nya, termasuk Article biasa. Cek juga walau site lo cuma pakai satu tipe schema doang.
Gimana cara tau CMS gue kena masalah double-escaping ini? Cek raw output JSON-LD di page source lo, cari entity HTML yang ke-tulis mentah di dalam string JSON, kayak ampersand atau tanda kutip yang ke-escape tapi gak pernah balik jadi karakter biasa. Kalau nemu, ada sesuatu di upstream yang nge-escape value-nya sebelum sampe ke JSON serialization.
Yang Perlu Lo Cek Sekarang Juga
Jalanin homepage dan satu halaman artikel lo lewat Rich Results Test hari ini, jangan nunggu update konten berikutnya. Kalau nama author-nya resolve dan raw JSON-LD-nya gak ada entity double-escaped, lo udah aman di dua sisi. Kalau salah satu gagal, empat fix di atas itu penyebab sebenarnya, bukan masalah JavaScript rendering atau delay indexing Search Console, yang biasanya jadi jawaban pertama di guide troubleshooting generik.